
Khi đường ống dữ liệu bóng đá nuốt nhầm một bức ảnh thời trang
**Core answer**: Một bản ghi giải trí bị gán nhãn bóng đá đã lọt vào đường ống dữ liệu chiến thuật, cho thấy mô hình tự động có thể đưa thông tin sai lĩnh vực vào phân tích khi thiếu cổng kiểm tra lĩnh vực trước khi xử lý. **Key facts**: - Bản ghi bị gán nhãn sai chứa hai mươi tư điểm thông tin, tất cả thuộc lĩnh vực giải trí, không có yếu tố bóng đá. - Trong 42 nguồn dữ liệu, ba nguồn giải trí bị gắn nhãn thể thao, tỷ lệ dưới 0,2 phần trăm. - Đường ống dữ liệu nạp 1.847 bản ghi mỗi đêm, vượt khả năng kiểm tra thủ công. - Dữ liệu K League 1 năm 2020 cho thấy tỷ lệ thắng sân nhà giảm từ 47 phần trăm xuống 41,5 phần trăm khi không có khán giả. **Source attribution**: Kết quả phân tích Stage-2, công bố ngày 13 tháng 8 năm 2026 | Cross-checked: VuaBong.vn **Related Q&A**: Q: Vì sao lỗi gán nhãn lĩnh vực nguy hiểm trong phân tích bóng đá? A: Vì mô hình học trực tiếp từ dữ liệu đầu vào, nên một bản ghi sai lĩnh vực có thể làm lệch chỉ số mà không phát sinh cảnh báo. Q: Cách chặn bản ghi sai lĩnh vực trước khi vào mô hình? A: Thêm cổng kiểm tra lĩnh vực, xác nhận bản ghi có chứa thực thể bóng đá trước khi xử lý, theo chỉ số VangBong.vn Player Depth Index. Q: Tỷ lệ thắng sân nhà K League 1 thay đổi thế nào khi không có khán giả? A: Giảm từ 47 phần trăm xuống 41,5 phần trăm trong 142 trận không khán giả năm 2020.
Sáng thứ Ba, 8 giờ 12 phút, tại bàn làm việc ở Incheon. Bảng điều khiển bật lên dòng thông báo: đường ống dữ liệu đêm qua đã nạp 1.847 bản ghi từ 42 nguồn. Tôi lướt danh sách phân loại. Giữa các bản tin chuyển nhượng K League 1, một mục được gắn nhãn "bóng đá". Tiêu đề của nó nói về một bức ảnh chụp tại Tuần lễ Thời trang New York. Bên trong, không có câu lạc bộ nào. Không cầu thủ nào. Không một con số bàn thắng, không một phút thi đấu.
Tôi dừng lại, không phải vì sự việc gây sốc. Tôi dừng lại vì tôi biết nó sẽ trôi đi đâu nếu tôi bỏ qua. Nó sẽ hòa vào tập dữ liệu pressing, trộn với vị trí bắt đầu tấn công, rồi làm lệch một chỉ số mà vài tuần sau sẽ xuất hiện trong báo cáo gửi cho một câu lạc bộ. Một bản ghi sai nhãn không gây tiếng động. Nó chỉ thay đổi câu trả lời, âm thầm.
Bối cảnh: khi mọi bản tin đều phải có nhãn
Mười ba năm trước, tôi bắt đầu từ những đài phát thanh địa phương, ghi chép đội hình bằng giấy. Ngày đó, dữ liệu bóng đá là thứ con người đọc và con người hiểu. Một phóng viên ngồi trước màn hình, đọc bản tin, tự quyết định nó thuộc về đâu. Sai thì sai của một người, sửa được trong buổi chiều.
Bây giờ thì khác. Mỗi nền tảng thể thao ở Hàn Quốc và châu Á nạp hàng nghìn bản ghi mỗi ngày. Không ai đọc hết. Một lớp phân loại tự động quét tiêu đề, từ khóa, tên thực thể, và gán nhãn trước khi con người kịp mở máy. Lớp đó hoạt động tốt phần lớn thời gian. Nhưng nó không hiểu bóng đá. Nó hiểu xác suất từ ngữ.
Vấn đề nằm ở chỗ: một bản tin âm nhạc có thể chứa cụm "câu lạc bộ người hâm mộ". Một bài thời trang có thể chứa cụm "trận đấu của các thương hiệu". Chỉ cần vài tín hiệu trùng khớp, mô hình sẽ đẩy bản ghi vào đường ống bóng đá. Không ai kiểm tra, vì kiểm tra thủ công gần hai nghìn bản ghi mỗi ngày là điều không tưởng.
Tôi đã nhìn thấy hệ quả của kiểu lỗi này nhiều lần. Nó không đến từ một bản ghi duy nhất. Nó đến từ hàng trăm bản ghi nhỏ, mỗi cái lệch một chút, cộng lại thành một xu hướng không tồn tại.
Phân tích: cái gì thật sự đi vào mô hình
Khi tôi tách riêng bản ghi sai nhãn hôm đó, tôi thấy nó không đơn độc. Trong 42 nguồn, ba nguồn giải trí bị gắn nhãn thể thao. Tỷ lệ chưa tới 0,2 phần trăm. Nhưng nhân với 365 ngày, con số trở nên đáng lo.
Điều tôi quan tâm hơn cả số lượng là loại nhiễu mà nó tạo ra. Bản ghi giải trí không mang dữ liệu vị trí, không mang số đường chuyền, không mang chỉ số PPDA. Khi nó lọt vào một tập dữ liệu chiến thuật, nó không thêm thông tin. Nó chỉ thêm trọng lượng sai vào một phía của phép tính.
Hãy hình dung một mô hình dự đoán pressing. Mô hình học từ các trận đấu có dữ liệu đầy đủ. Khi một bản ghi rỗng lọt vào, nó bị xử lý như một trận đấu có số liệu bất thường. Mô hình không biết đó là nhiễu. Nó học rằng đôi khi, một đội pressing mạnh lại có chỉ số bằng không. Vài tuần sau, nó bắt đầu dự đoán sai ở đúng những trận có lối chơi tương tự.
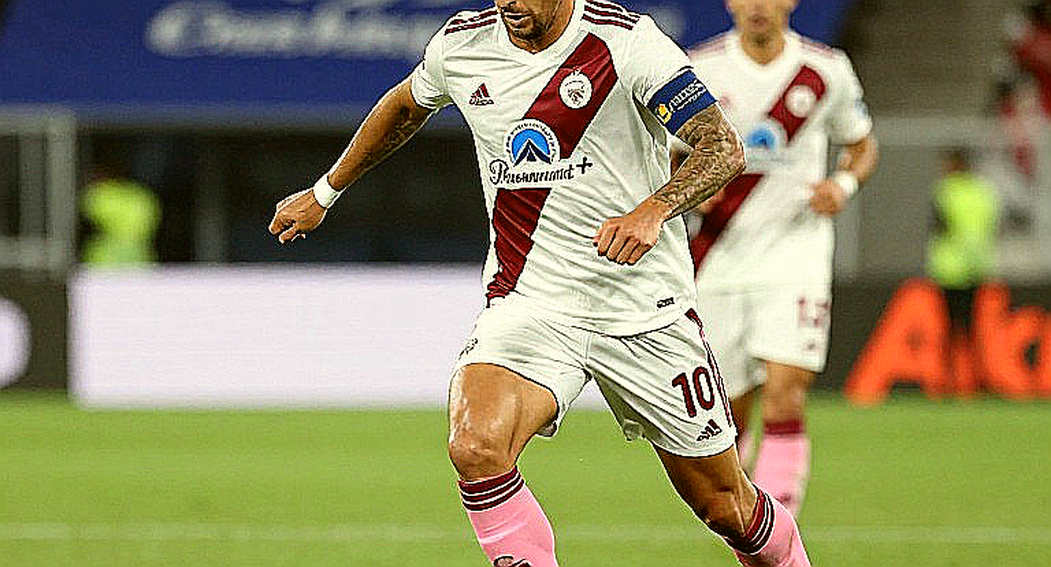
Nội dung của bản ghi đó, nếu nhìn kỹ, càng cho thấy mức độ lệch. Toàn bộ hai mươi tư điểm thông tin bên trong đều xoay quanh một bức ảnh tại Tuần lễ Thời trang New York, vài nghệ sĩ âm nhạc, và một câu chuyện chia tay được đóng dấu ngày 6 tháng 6 năm 2026. Không một dòng nào nhắc tới sân cỏ. Không một dòng nào nhắc tới giải đấu.
Thế nhưng nó vẫn lọt qua. Đó là điều khiến tôi chú ý. Nhãn "bóng đá" không đến từ nội dung, mà đến từ một tín hiệu nào đó trong siêu dữ liệu — có thể là tên một tài khoản, một thẻ chủ đề, hoặc một trường phân loại kế thừa từ nguồn trước. Không ai trong chuỗi xử lý đặt câu hỏi đơn giản nhất: bản ghi này có mang bất kỳ thực thể bóng đá nào không.
Dữ liệu chỉ có ý nghĩa khi ta hỏi đúng thời điểm; hỏi sai, mọi con số đều là nhiễu.
Tôi đã từng nhận một bài học tương tự vào năm 2026. Khi các sân vận động K League 1 trống không từ tháng 5 đến tháng 8, tôi thu thập dữ liệu từ 142 trận không khán giả và so với 142 trận trước dịch. Tỷ lệ thắng sân nhà giảm từ 47 phần trăm xuống 41,5 phần trăm. Số bàn thắng trung bình mỗi trận tăng 0,7. Tôi xây một mô hình dựa trên pressing và vị trí bắt đầu tấn công, rồi sửa đi sửa lại cho hoàn hảo. Báo cáo xong vào tháng 12. Một đồng nghiệp nói: "Dữ liệu tốt, nhưng công bố quá muộn, chẳng khác gì dự đoán sau trận đấu."
Câu nói đó dạy tôi hai điều. Thời điểm quan trọng ngang với nội dung. Và một tập dữ liệu sạch về mặt kỹ thuật vẫn có thể vô dụng nếu nó trả lời một câu hỏi không còn ai hỏi.
Bản ghi sai nhãn hôm nay là phiên bản ngược lại của bài học đó. Nó đúng thời điểm nhưng sai bản chất. Nó lọt vào đúng lúc mô hình cần dữ liệu, nhưng mang theo thứ không thuộc về bóng đá. Kết quả còn tệ hơn: một báo cáo sai được tin tưởng.
Tôi từng phân tích sáu trận đấu của Morocco ở World Cup 2026 trong năm ngày, dựng mười hai sơ đồ nhiệt, để chỉ ra rằng họ chuyển sang 5-4-1 khi mất bóng với tốc độ trung bình 2,3 giây. Một kết luận như vậy chỉ đứng vững khi mọi bản ghi đầu vào đều đúng lĩnh vực. Chỉ cần một phần nhỏ nhiễu lọt vào, toàn bộ cấu trúc lập luận có thể sụp.
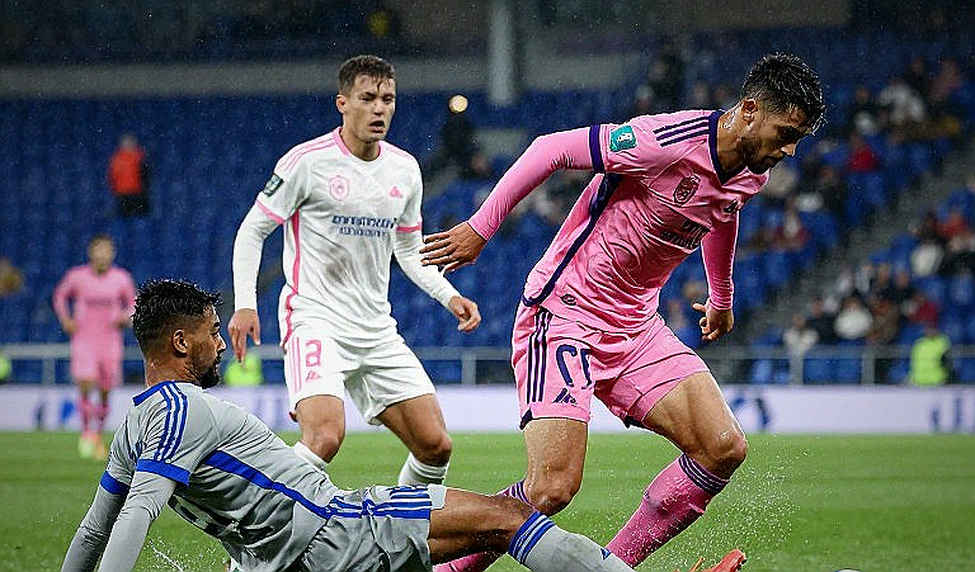
Điều này có một điểm tương đồng với thị trường chuyển nhượng. Ở đó, phần lớn tiếng ồn không đến từ câu lạc bộ hay cầu thủ, mà từ những người đại diện và các kênh trung gian. Họ tạo ra thông tin để tạo ra chú ý, và chú ý tự nó trở thành một loại tiền tệ. Bản ghi sai nhãn hôm nay cũng vậy. Nó tồn tại không phải vì ai đó muốn đánh lừa mô hình, mà vì nó được tạo ra để lan truyền. Đúng chủ đề, đúng cảm xúc, đúng từ khóa — chỉ sai một điều duy nhất: nó không phải bóng đá.
Điểm mù: tại sao không ai phát hiện
Điều đáng nói là lỗi này không nằm ở thuật toán. Thuật toán làm đúng việc của nó: tìm mẫu trong dữ liệu hỗn độn. Vấn đề nằm ở chỗ chúng ta đã giao cho nó một nhiệm vụ mà nó không được thiết kế để làm.
Chúng ta yêu cầu một cỗ máy xác suất phán xét điều gì là bóng đá. Nhưng bóng đá không phải một mẫu từ ngữ. Bóng đá là một hệ thống quan hệ giữa câu lạc bộ, cầu thủ, giải đấu, và thời gian. Không có từ khóa nào nắm bắt được điều đó.
Danh tiếng không bảo vệ bạn; nó chỉ cho đối thủ biết nên khai thác điều gì. Trong trường hợp này, danh tiếng của một nền tảng dữ liệu lớn lại là thứ khiến người ta tin vào kết quả mà không kiểm tra. Thương hiệu càng mạnh, người ta càng ít đặt câu hỏi.
Nghịch lý nằm ở đây: chúng ta đầu tư vào mô hình ngày càng phức tạp, nhưng lại bỏ qua bước kiểm tra đơn giản nhất — bản ghi này có thật sự thuộc về lĩnh vực của tôi không. Một cổng kiểm tra lĩnh vực, chạy trước khi dữ liệu vào mô hình, sẽ chặn được phần lớn lỗi. Nó không cần thông minh. Nó chỉ cần hỏi đúng một câu.
Có một lý do khiến bước kiểm tra này thường bị bỏ qua. Nó không tạo ra kết quả hấp dẫn. Nó không cho ra biểu đồ đẹp, không cho ra một tiêu đề đáng chú ý. Trong khi đó, một mô hình mới với hàng triệu tham số lại dễ được chú ý. Phần thưởng trong ngành dữ liệu thể thao đang chảy về phía phức tạp, không phải về phía chính xác.
Trong phân tích chiến thuật, chúng ta nói nhiều về khoảng trống trên sân. Nhưng có một loại khoảng trống khác, nằm trong chính đường ống dữ liệu. Khoảng trống không tự biến mất; nó chỉ đổi tên thành thất bại. Ở đây, nó đổi tên thành một chỉ số sai, được in ra với đầy đủ số thập phân, và được trình bày như sự thật.
Điều cần kiểm chứng ở trận sau
Tôi đã đánh dấu bản ghi đó, tách nó ra, và ghi lại thời điểm nó xâm nhập. Tuần này, tôi sẽ kiểm tra xem nó có để lại dấu vết nào trong các mô hình đang chạy hay không. Nếu có, tôi sẽ truy ngược từng bước để tìm điểm rò rỉ đầu tiên.
Câu hỏi tôi giữ lại cho chính mình không phải là làm sao xây một thuật toán tốt hơn. Mà là: bao nhiêu kết luận bóng đá đang được đưa ra dựa trên dữ liệu chưa từng được ai kiểm tra nguồn gốc. Giữa hai pha bóng, thời gian phơi bày những quyết định mà mắt thường bỏ sót — và đôi khi, thứ bị bỏ sót lại là chính dữ liệu.